Dream Voice
わずか3秒のお手本音声から声をクローンし、オフライン完結でテキストを自由に読み上げる。
Windows 向けボイス生成ソフトです。
Concept
✨ Dream Voice とは
好きな声のサンプルを少しだけ聞かせるだけで、その声で好きな文章をしゃべらせられる ― それが Dream Voice のコンセプトです。3〜10秒程度の音声サンプルと書き起こしテキストを与えるだけで、 その人の声の特徴を抽出(いわゆるゼロショット音声クローン)し、 抽出した声(=「スピーカー」)を使って任意のテキストを読み上げた音声を生成できます。
- 一度セットアップすれば完全にオフラインで動作。音声データは自分の PC の中だけで完結し、外部サーバーへアップロードされることはありません。
- 淡いパステルカラーとガラス質感を基調にした、ファンタジックで柔らかい「夢(Dream)」らしい世界観のデザイン。
Use cases
🎯 主な用途
動画クリエイター・ゲーム開発者・ボイスドラマ制作者から、自分の声を配布・販売したい方まで、どなたでも簡単にご利用いただけます。
Overview
🗺️ 全体構成(画面タブ)
アプリの上部ナビゲーションは、次の6つに分かれています。詳しい使い方は「機能別詳細ガイド」で解説しています。
Free vs Full Plugin
🆓 無料版と Full プラグイン版の違い
Dream Voice は、声のクローン技術そのものは無料でしっかり体験できるうえで、より便利に・より本格的に使うための機能を「Full プラグイン」として追加導入できる構成になっています。
🆓 無料版
追加インストールなしで利用可- お手本音声から声を抽出する「ゼロショット音声クローン」を体験可能
- 対応言語は日本語のみ
- 生成できる音声の長さは約3秒まで
- スピーカーの管理・パッケージ共有は利用可能
- アトリエ(ボイスミキサー・ランダムボイスなど)も利用可能
🧩 Full プラグイン版
プラグイン追加で制限解除- 対応言語が英語・中国語・韓国語にも拡大
- 音声生成の長さ制限が解除(無制限)
- 複数キャラクターの会話を一括生成する「会話を作る」機能
- ボイススタイル(不機嫌・甘え・囁きなど)の追加スタイルが利用可能
- 作成したスピーカーパッケージ(.dvpkg)の商用利用が可能に(声の配布・販売にも利用できます)
さっそく使ってみる
インストールから最初の声づくり・読み上げまでは「クイックスタート」でまとめて解説しています。
Quickstart
🚀 クイックスタート
インストールから、最初の声づくり(スピーカー登録)・テキスト読み上げまでを一気に解説します。
動作確認済み環境
📦 インストール手順
ZIP ファイルをダウンロードして解凍する
配布ページから ZIP ファイルをダウンロードし、任意の場所に解凍します。
セットアップファイルを実行する
DreamVoice_Setup で始まるファイルをダブルクリックして開きます。
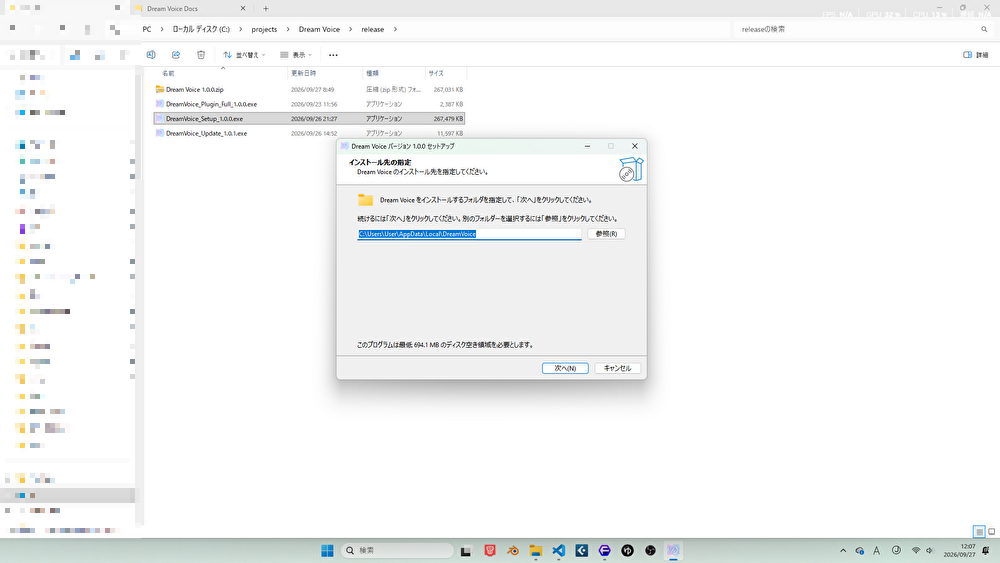
インストール完了後、自動で起動する
インストールが完了すると、自動でアプリケーションが起動します。以降は Windows のスタートメニューからいつでも起動できます。
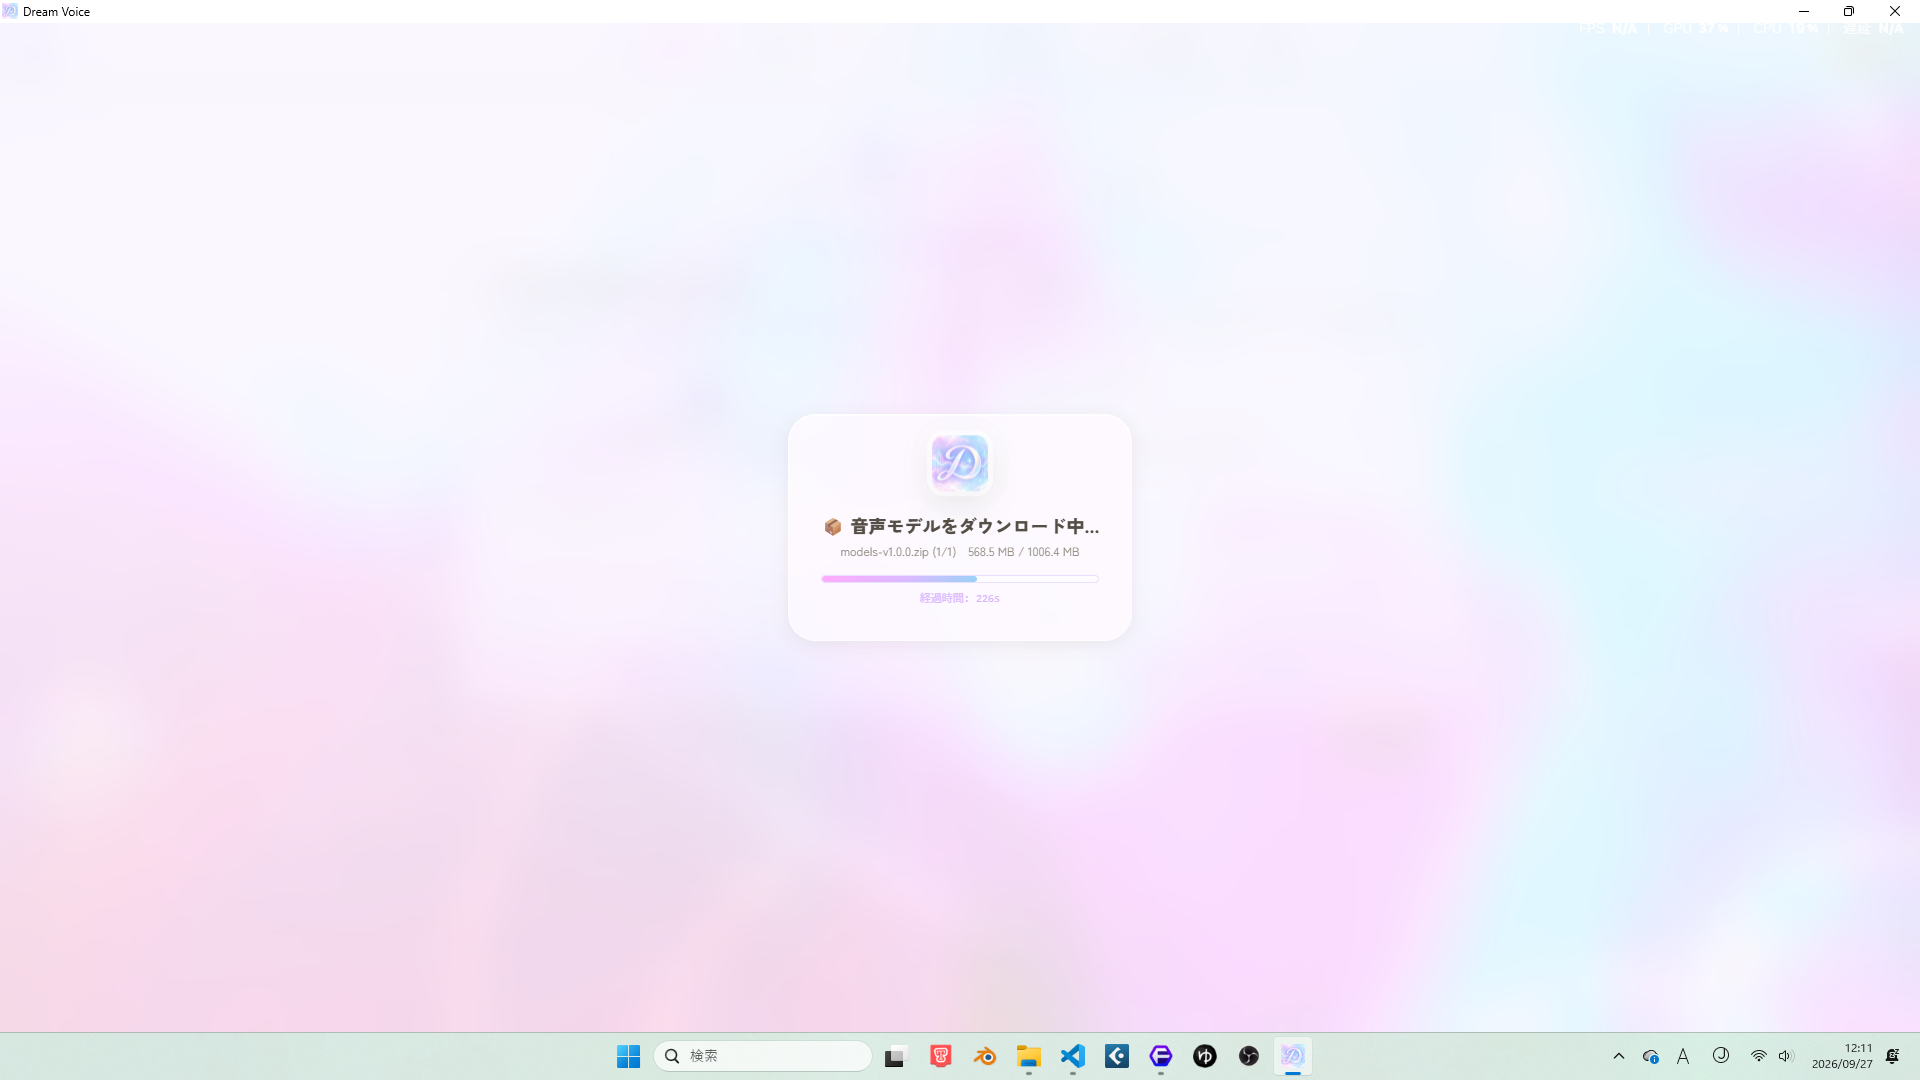
初回のみ「モデルのダウンロード」が実行される
完了すると自動でアプリが起動します。通信環境によっては 15 分程度かかる場合があります。ダウンロード中は、はじめに利用規約の確認画面が表示されます。最後までスクロールして内容をご確認のうえ「同意して始める」を押してください(ダウンロード自体はこの画面の裏で並行して進みます)。以降の起動では、この画面は表示されず完全にオフラインで動作します。
🎙️ 声を覚えさせる(スピーカーを作る)
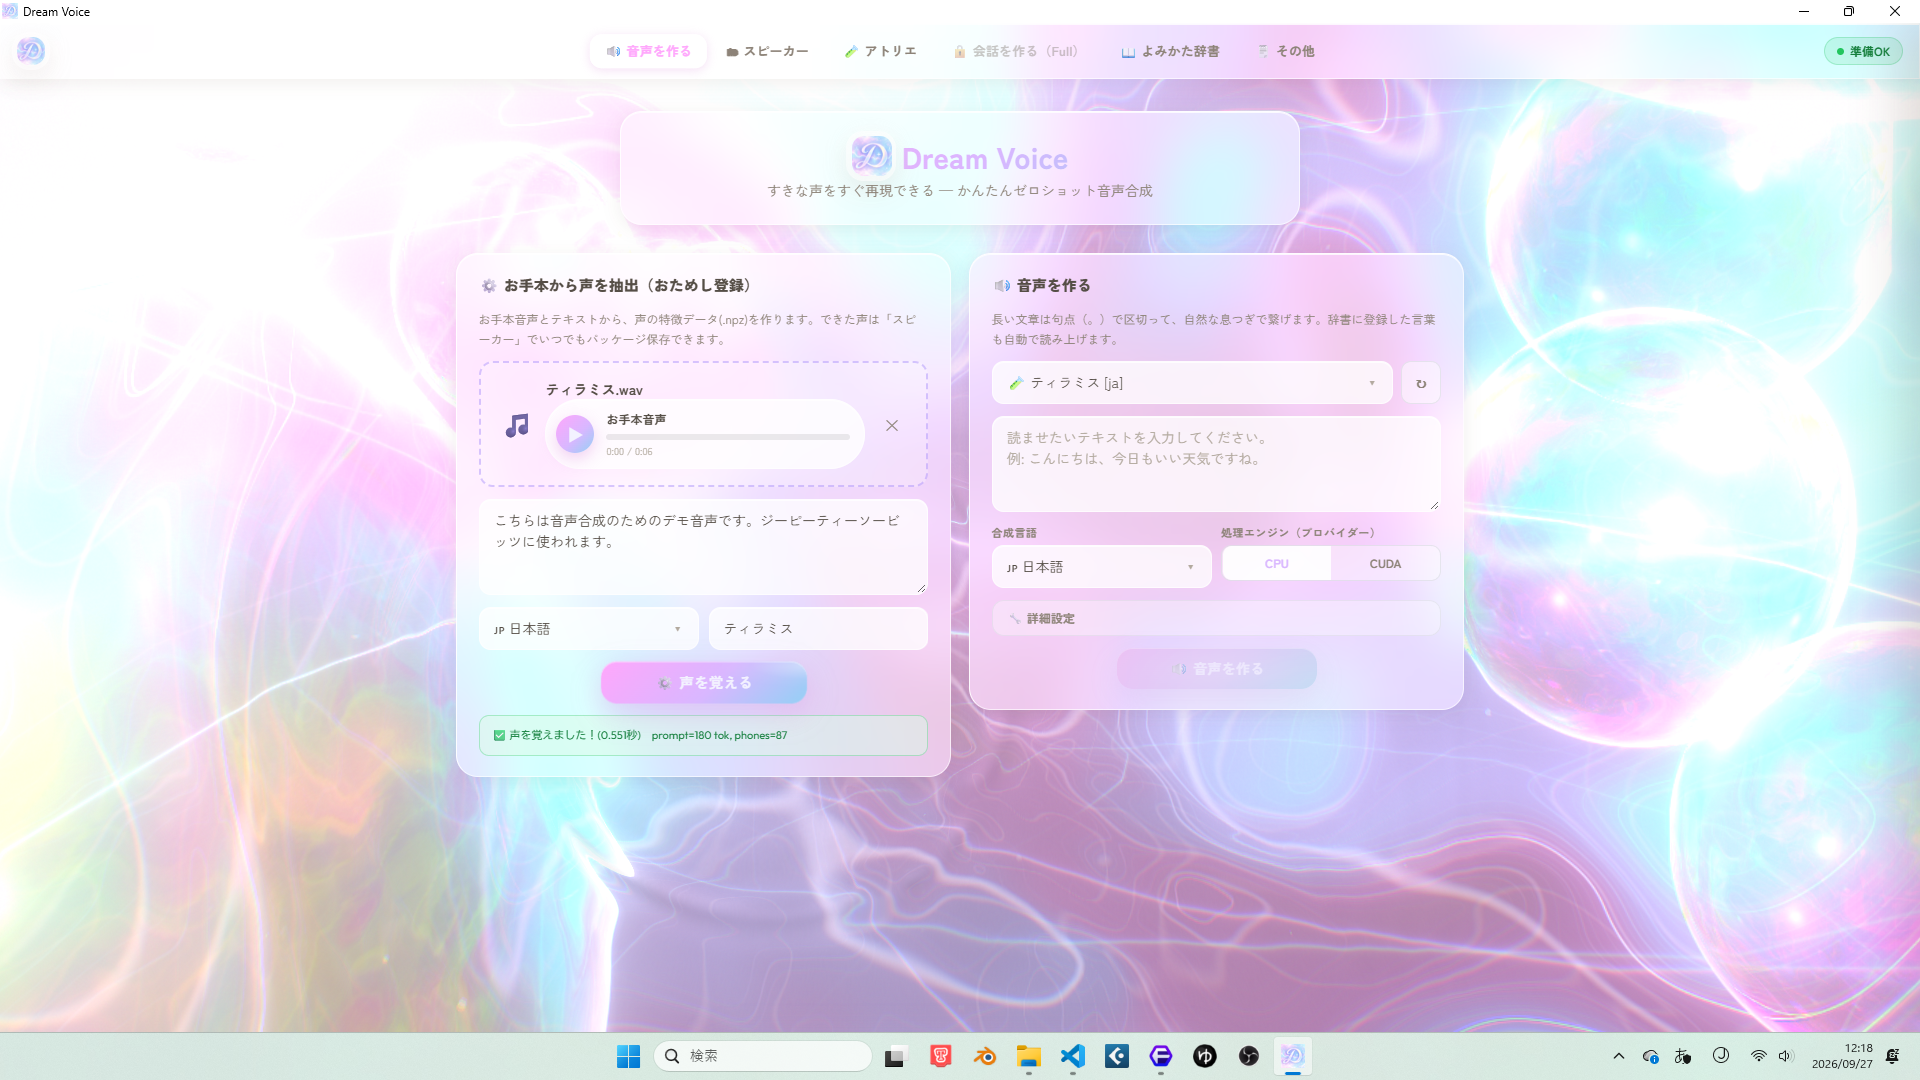
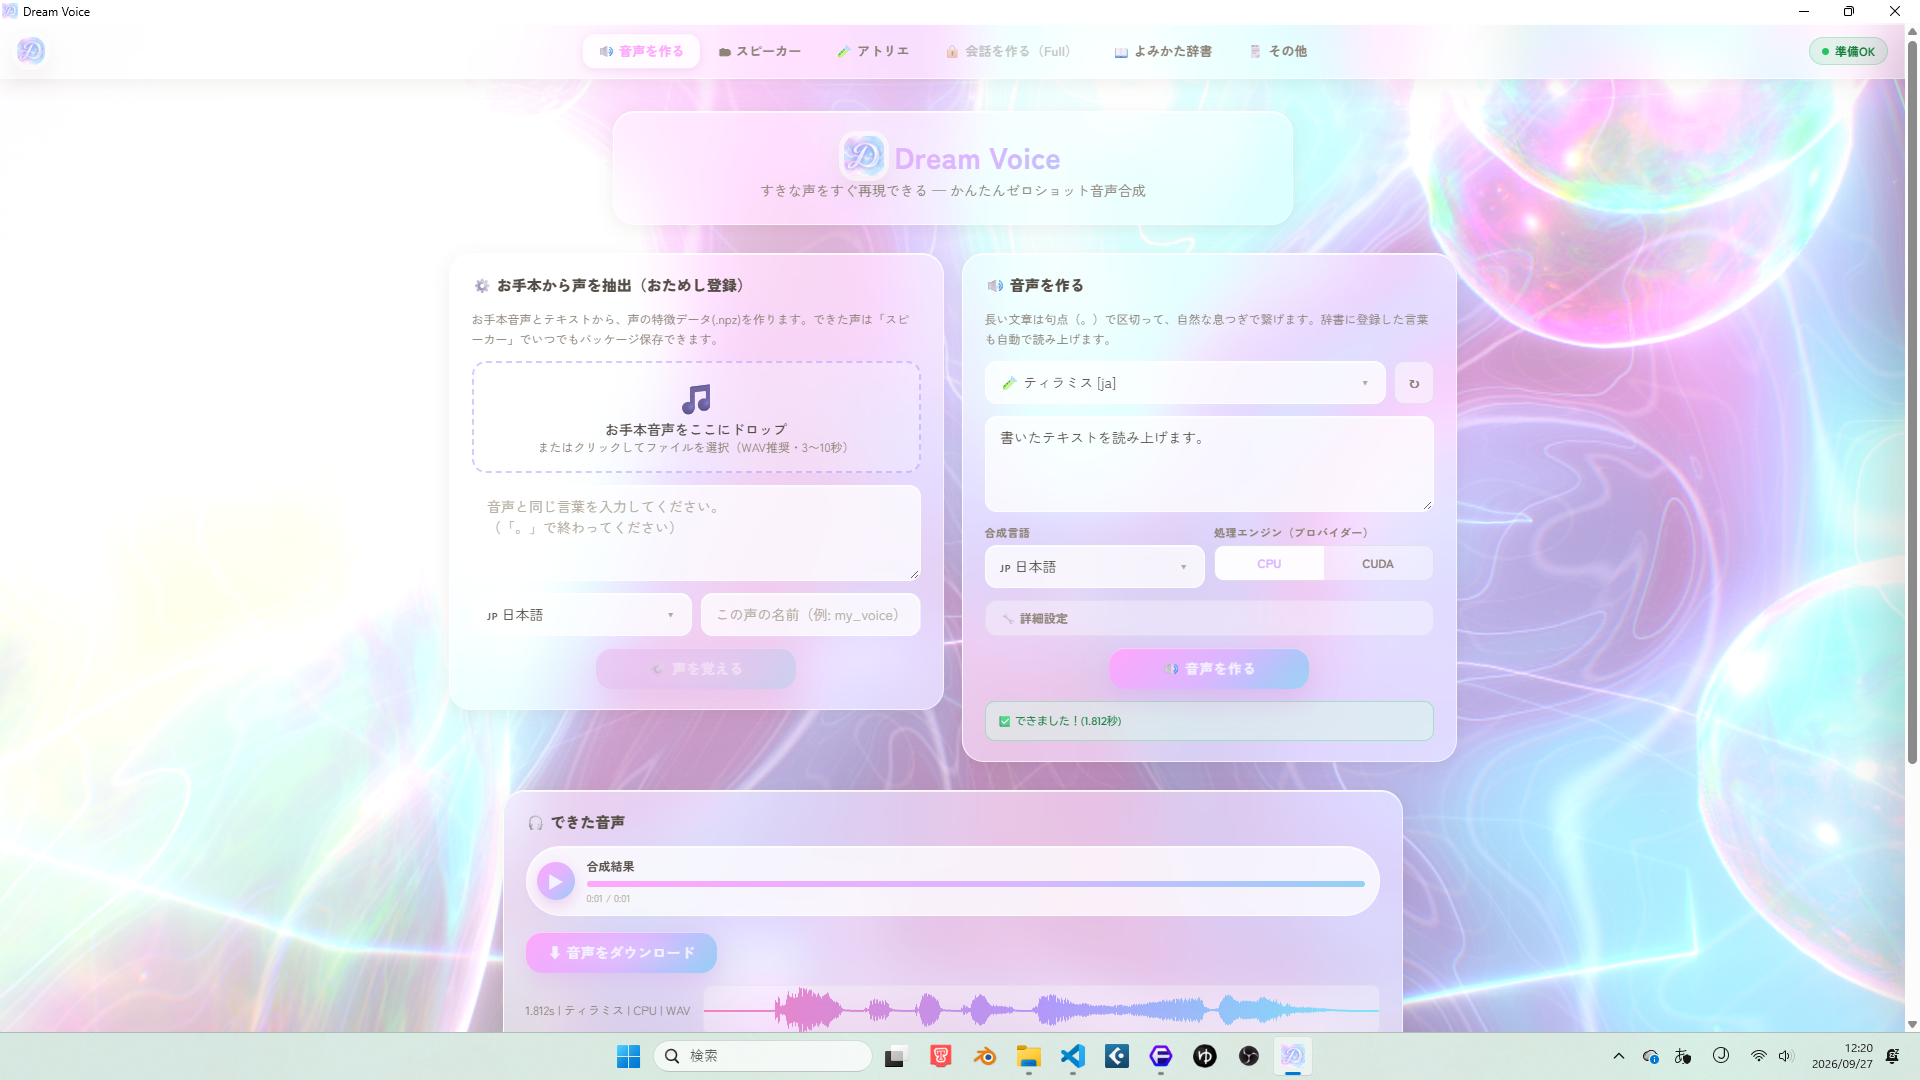
アプリが起動したら、まずは「🔊 音声を作る」タブの左側パネルで、お手本の声を登録してみましょう。
お手本音声をアップロードする
WAV 形式の音声ファイル(3〜10秒推奨)を、ドロップゾーンにドラッグ&ドロップするか、クリックして選択します。
書き起こしテキストを入力する
アップロードした音声と一致する言葉を、テキスト欄に入力します。
言語と声の名前を指定して「声を覚える」を押す
日本語/英語/中国語/韓国語から言語を選び、わかりやすい名前を付けます(無料版では日本語のみ利用できます)。しばらく待つと、声の特徴データが作成されます。
🔊 テキストを読み上げる
声ができあがったら、右側の「音声を作る」パネルでさっそく読み上げてみましょう。
スピーカーを選ぶ
先ほど作成した声を、スピーカー選択欄から選びます。
読ませたいテキストを入力する
長い文章は句点(。)などで自動的に文単位に分割され、自然な間(ま)をとりながら結合されます。
処理エンジンを選んで生成する
CPU または CUDA(対応 GPU) を選択できます。GPU があればより高速に生成できます。生成された音声はその場で再生でき、WAV/MP3 など指定した形式でダウンロードできます。
🎉 これで基本の使い方は完了です
スピーカーの管理・アトリエでの声の実験・会話を作る機能など、さらに詳しい使い方は「機能別詳細ガイド」をご覧ください。
Feature Guide
📚 機能別詳細ガイド
各タブの使い方を、詳しく解説します。
🔊 音声を作る(メイン機能)
声を覚える(お手本から声を抽出)
- WAV 形式の音声ファイル(3〜10秒推奨)をドラッグ&ドロップ、またはクリックしてアップロードします。
- 音声と一致する書き起こしテキストを入力します。
- 言語(日本語/英語/中国語/韓国語)と、この声の名前を指定して「声を覚える」を押すと、その声の特徴データが作成され、以後「スピーカー」として選択できるようになります。
音声を作る(読み上げ)
- 登録済みのスピーカーを選び、読ませたいテキストを入力します。
- 長い文章は句点(。)などで自動的に文単位に分割され、自然な間(ま)をとりながら結合されます。
- よみかた辞書に登録した言葉は自動的に置き換えて読み上げられます。
- 合成言語(日本語/英語/中国語/韓国語)を選べます。
- 処理エンジンとして CPU または CUDA(対応 GPU) を選択でき、GPU があればより高速に生成できます。
- 「詳細設定」を開くと、読み上げの表現力に関わる細かいパラメータ(ランダム性の強さ、話速など)や、CPU 利用時に使える高速合成エンジンの有効化も調整できます。
- 生成された音声はその場で再生でき、指定した形式(WAV/MP3、サンプルレート、モノラル・ステレオ)でダウンロードできます。
🆓 無料版と Full 版の違い
無料版では、生成できる音声は日本語のみ・約3秒までに制限されています。「Full」プラグインを追加で導入すると、この制限が解除され、英語・中国語・韓国語への対応、無制限の長さでの音声生成、後述の「会話を作る」機能、追加のボイススタイルなどが利用できるようになります。
🗂 スピーカー(声の管理)
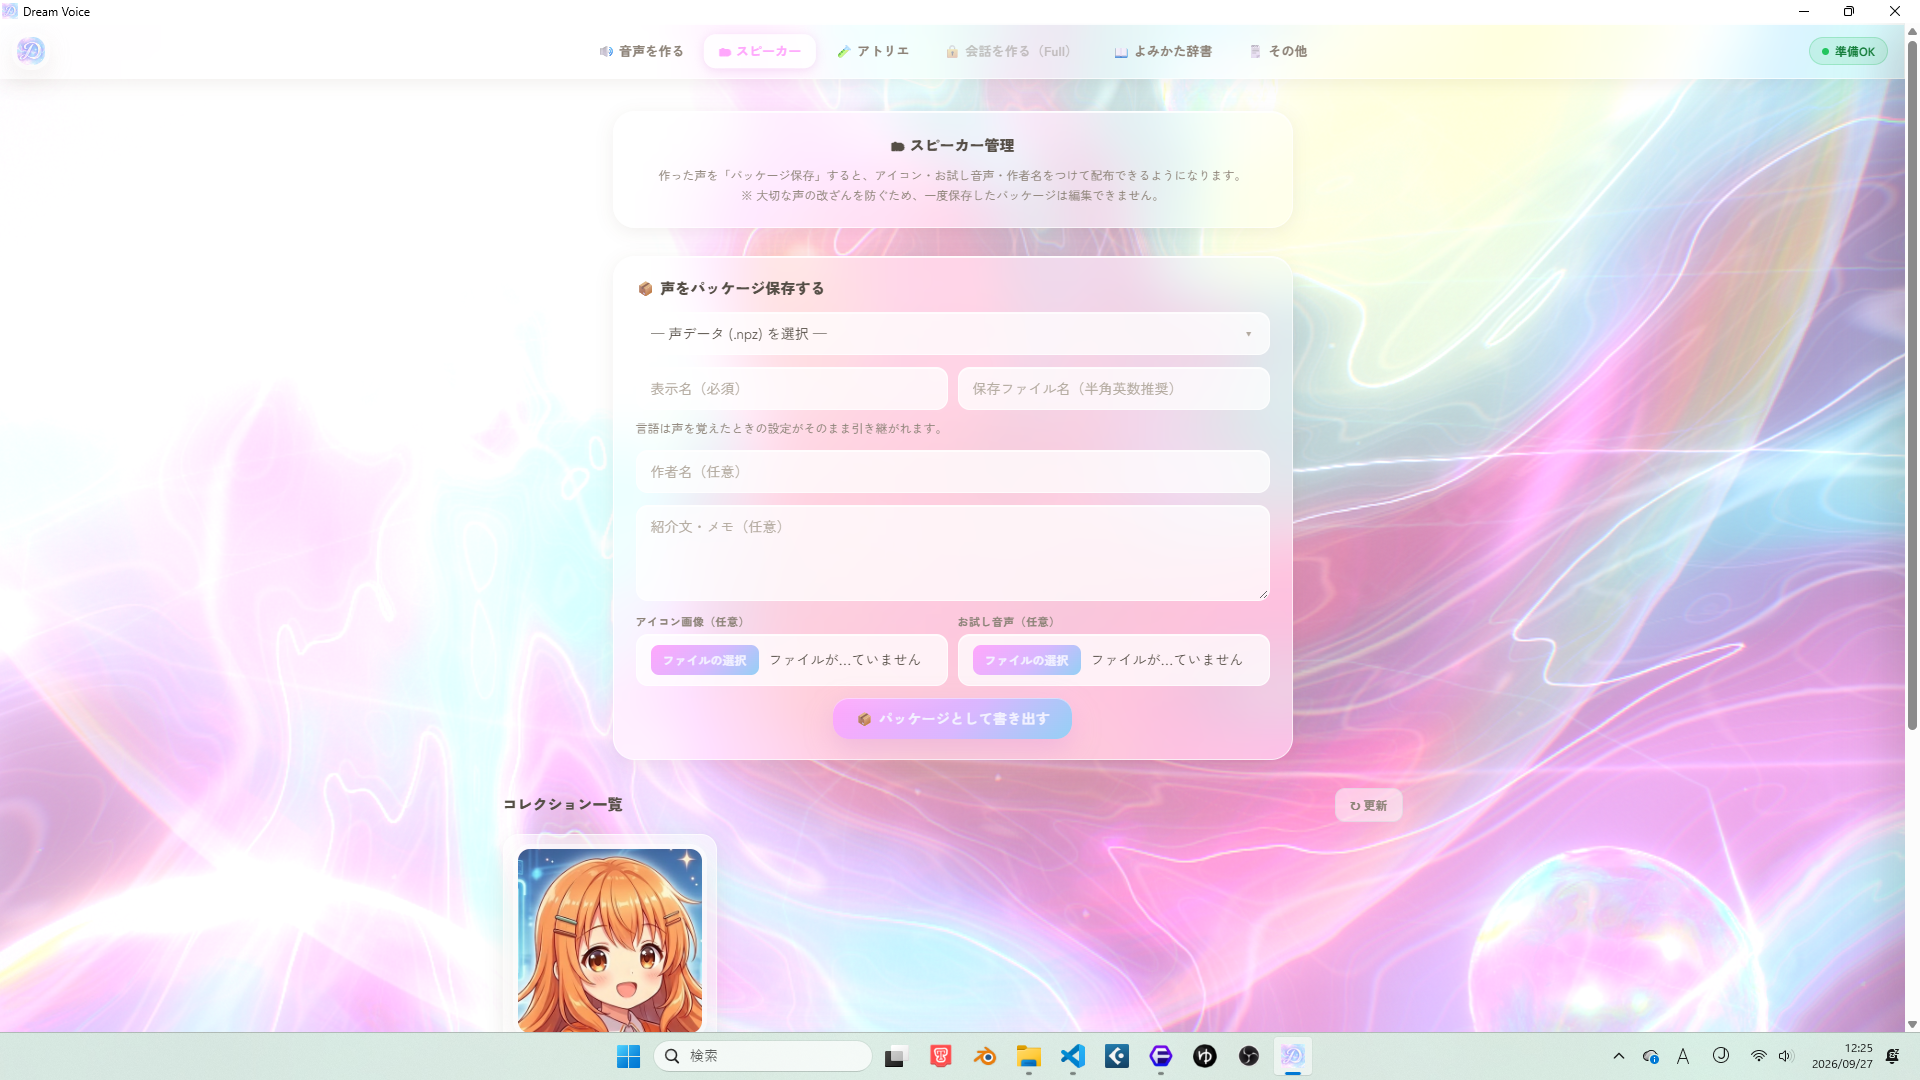
- これまでに作成した声(スピーカー)が一覧表示され、言語や作成日時などを確認できます。
- 不要な声は削除できますが、即座に完全削除されるのではなく、一定期間(48時間)は「ゴミ箱」に保持されるため、誤って削除してしまっても復旧の余地があります。
- 声はパッケージ化(
.dvpkg形式)して、アイコン画像・デモ音声・作者名・説明文つきの「話者パッケージ」として書き出すことができます。これは他の Dream Voice ユーザーに配布・共有できる自己完結型のファイルです。 - 他の人から受け取った
.dvpkgファイルを読み込んで、自分のスピーカー一覧に追加することもできます。 - 一度パッケージ化した声は、中身を後から書き換えることができません(削除して作り直すのみ)。これは配布後に改造されてしまうことを防ぐための仕様です。
- Full限定 Full プラグイン導入後は、作成したスピーカーパッケージを商用利用することも可能になります(声の配布・販売など)。
🧪 アトリエ(実験的な声づくり機能)
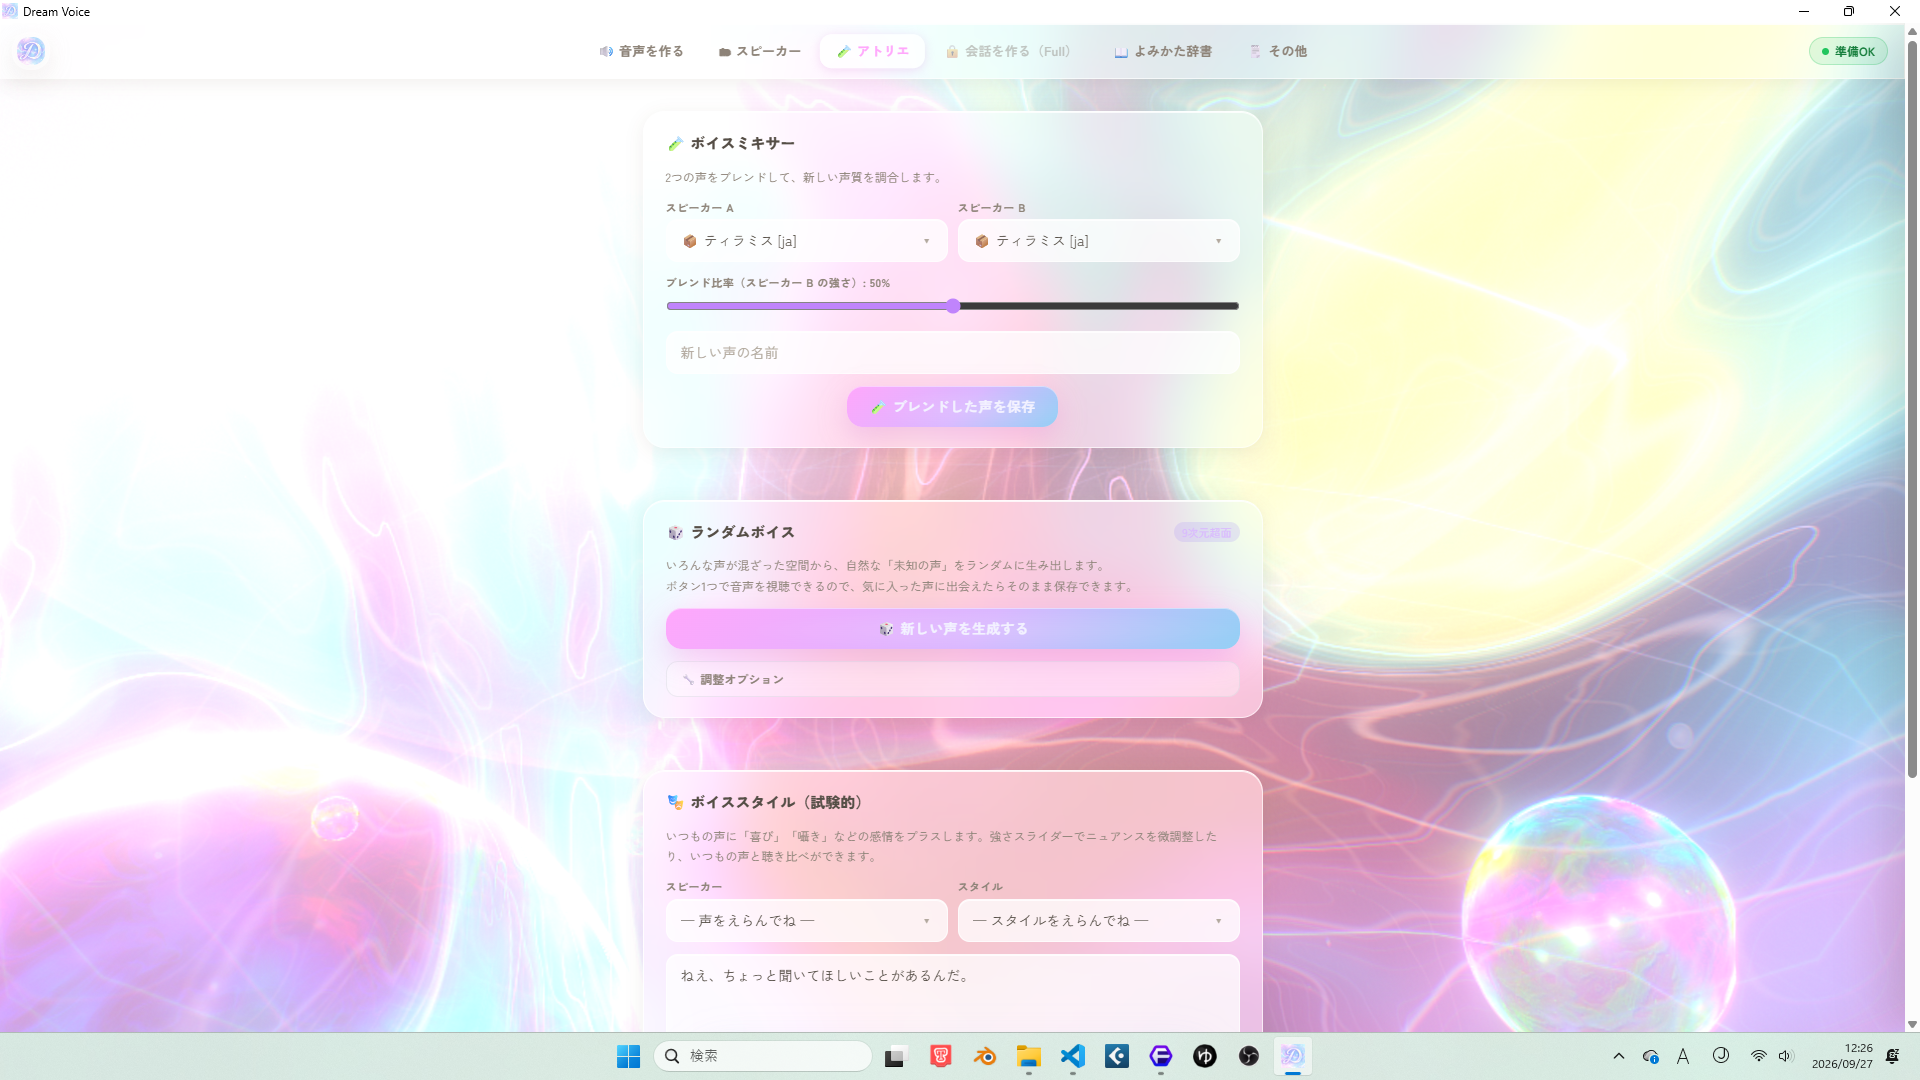
ボイスミキサー
2つの既存スピーカーを選び、混ぜる比率を指定して、両者の中間のような新しい声を作成できます。
ランダムボイス
あらかじめ学習された「声の空間」からランダムに声を1つサンプリングし、その場で試し読みできます。ボタン一つで気軽に未知の声と出会うことができ、気に入った声はそのままスピーカーとして保存できます。
ボイススタイル 一部 Full 限定(試験的機能)
- 既存のスピーカーに対して、「不機嫌」「甘え」「囁き」といった感情・声色の変化を後付けで適用できます。
- 変化の強さは 0(元の声のまま)〜3(かなり誇張) まで調整可能です。
- スタイル適用前後を聴き比べる機能もあります。
- 一部のスタイル(不機嫌・甘え・囁きなど)は Full 版限定です。
- 気に入ったスタイル結果は、新しいスピーカーとして保存できます。
💬 会話を作る Full 版限定
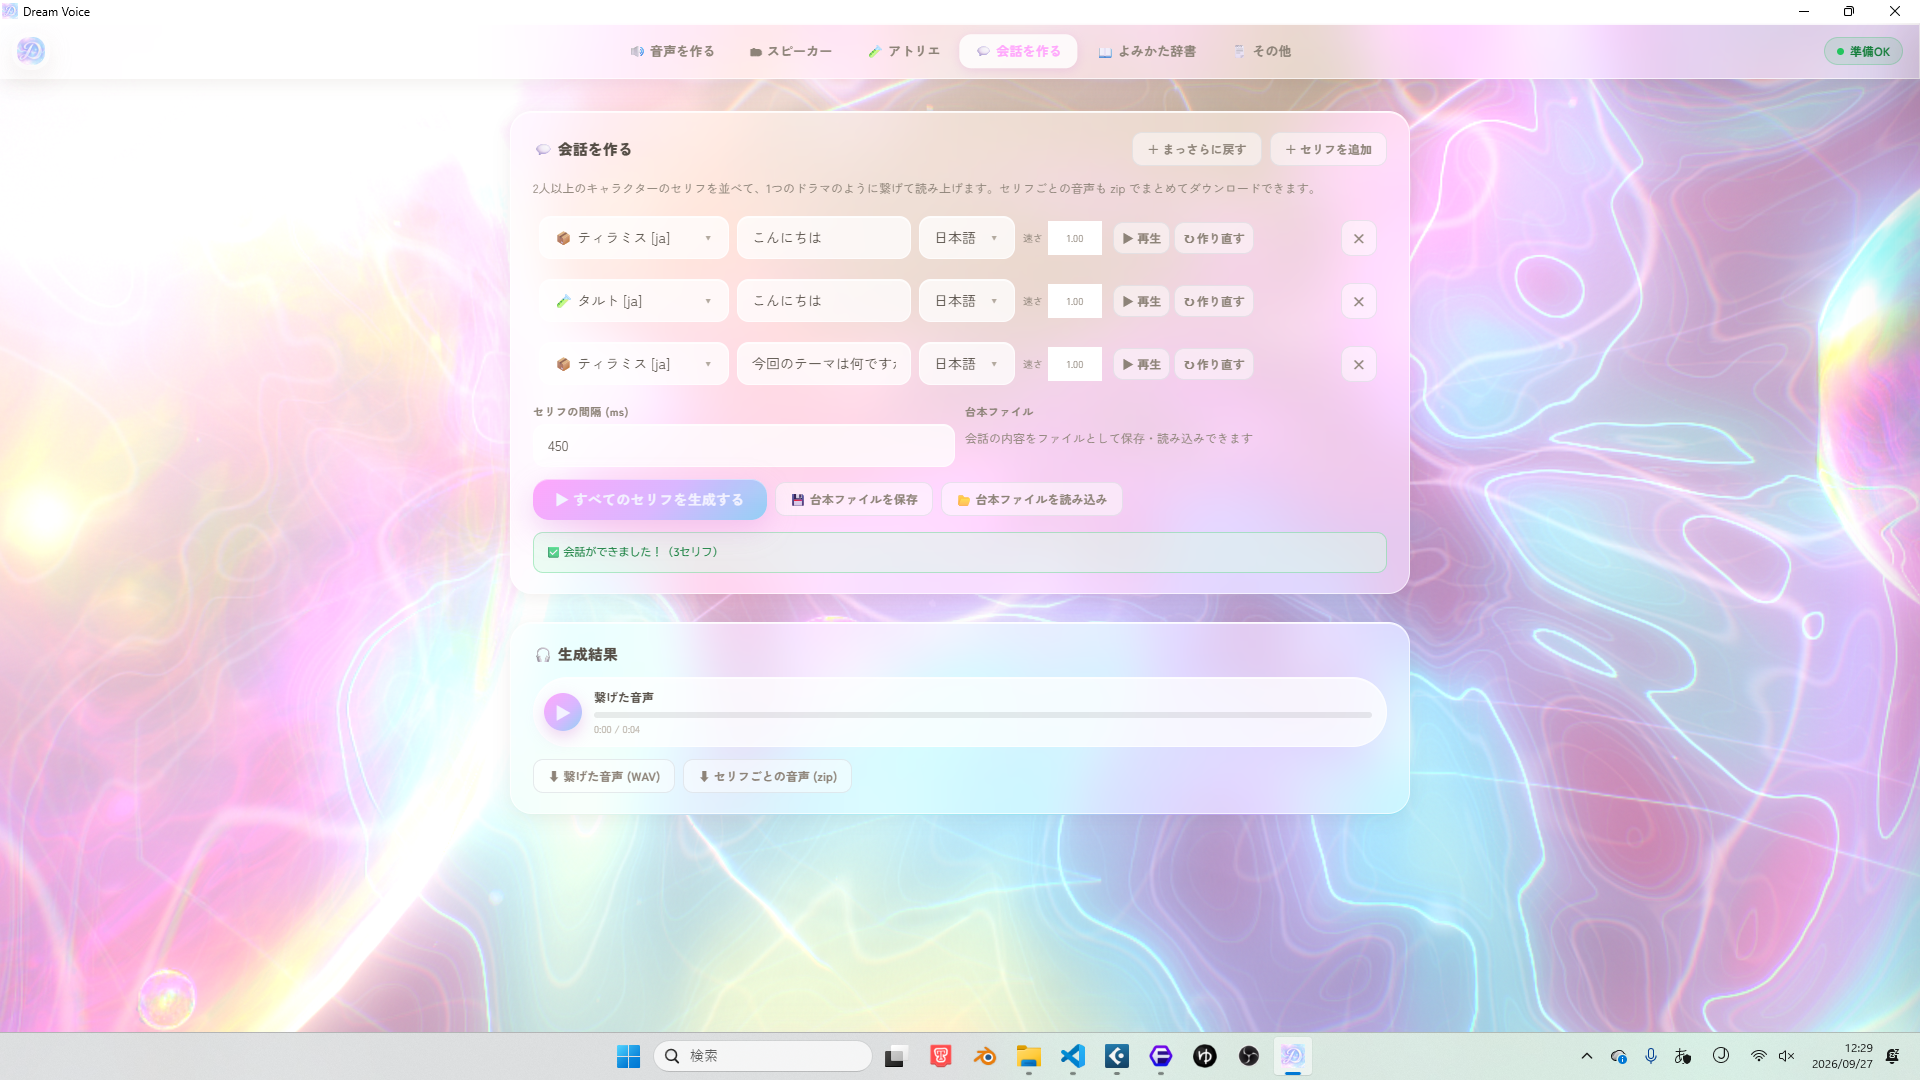
- 複数のキャラクター(スピーカー)のセリフをまとめて入力し、まるでドラマの台本のように連続した1本の音声として一括生成できます。
- セリフ同士の間隔(ミリ秒単位)を調整できます。
- 1行ずつ話速を個別に設定することもできます。
- 一部のセリフだけ生成し直したい場合、他の行は再利用しつつ、その行だけ再生成できます(無駄な待ち時間を減らす工夫)。
- 結合済みの音声(1ファイル)と、セリフごとの個別音声をまとめた zip の両方をダウンロードできます。
- 台本(セリフの内容)はファイルとして保存・読み込みができるため、続きを別の日に作業したり、複数の台本を管理したりできます。
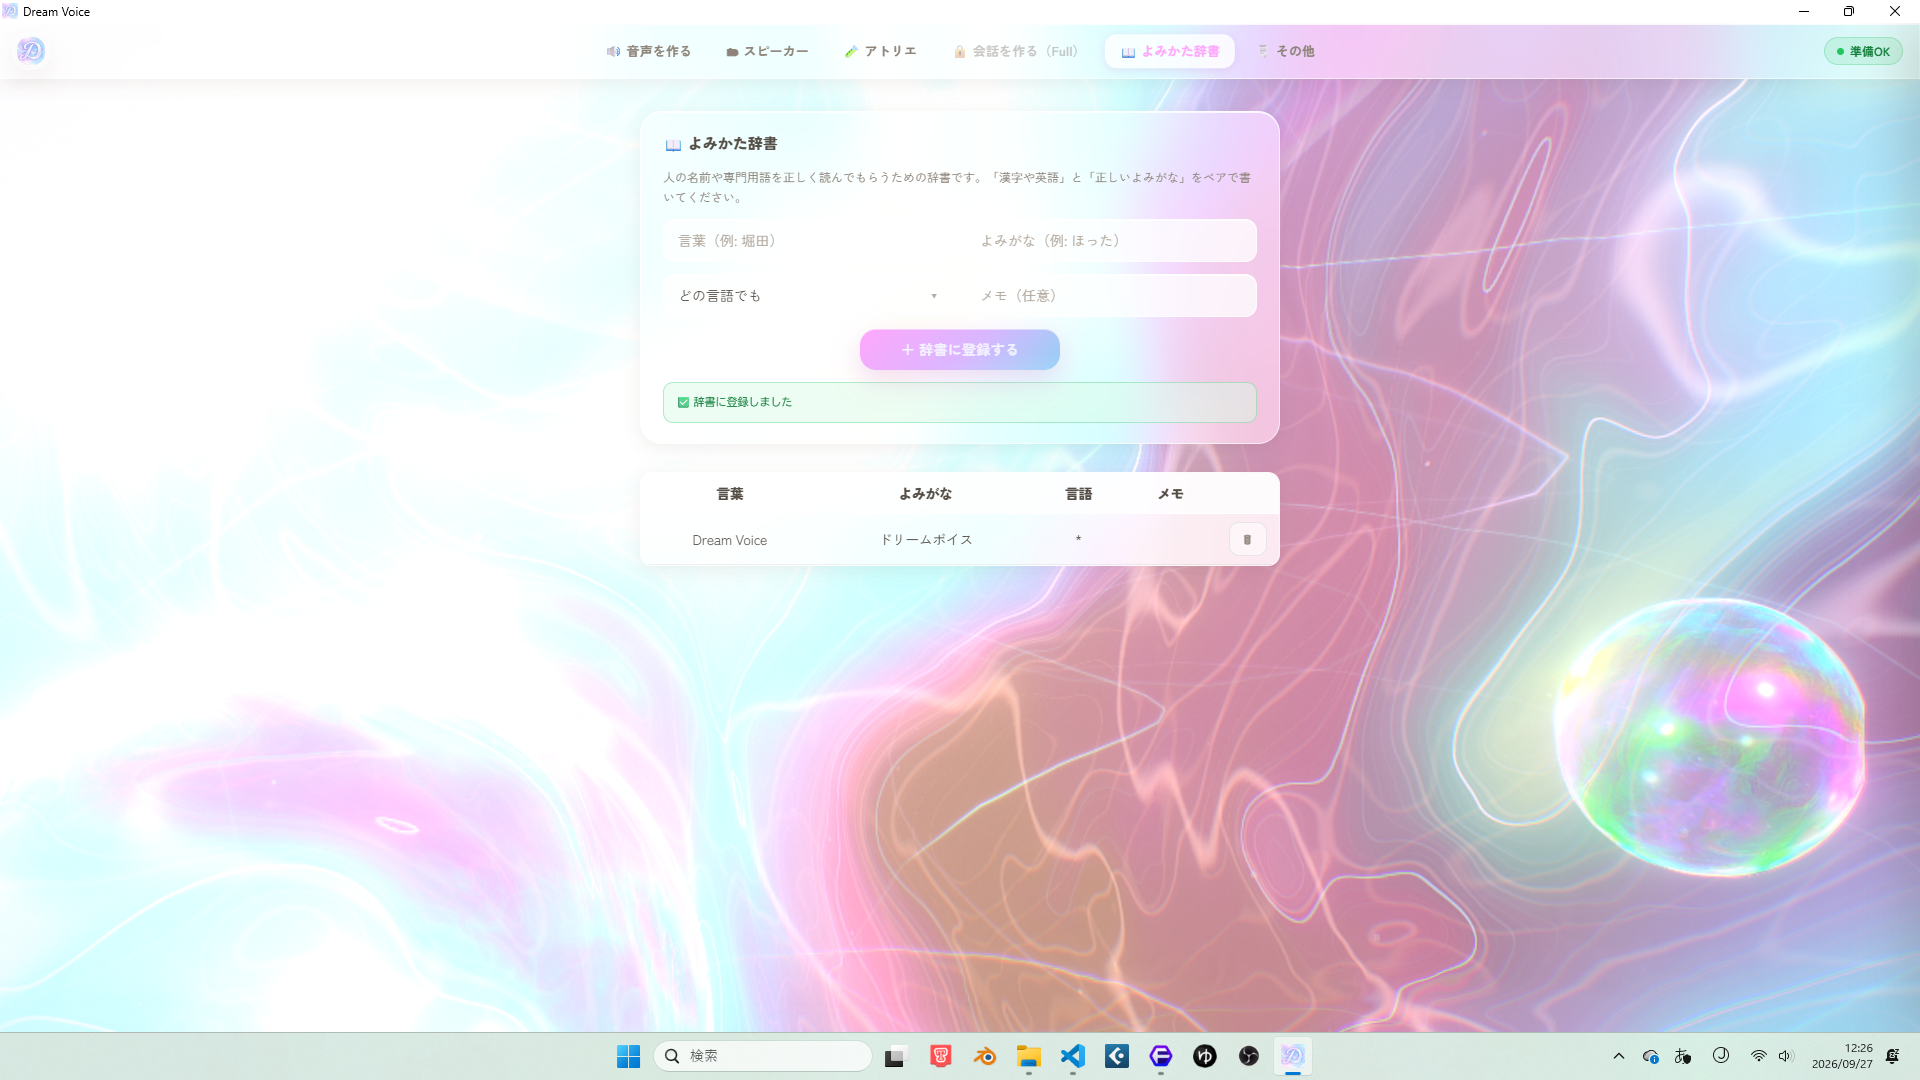
📖 よみかた辞書
- 「特定の言葉をこう読んでほしい」というルールを登録しておける辞書機能です(人名・固有名詞の読み間違い対策など)。
- 言語ごとに個別のルールを設定することも、すべての言語に共通のルールとして設定することもできます。
- 登録しておくと、以後「音声を作る」で入力したテキスト内の該当する言葉が自動的に読み方へ置き換えられてから読み上げられます。
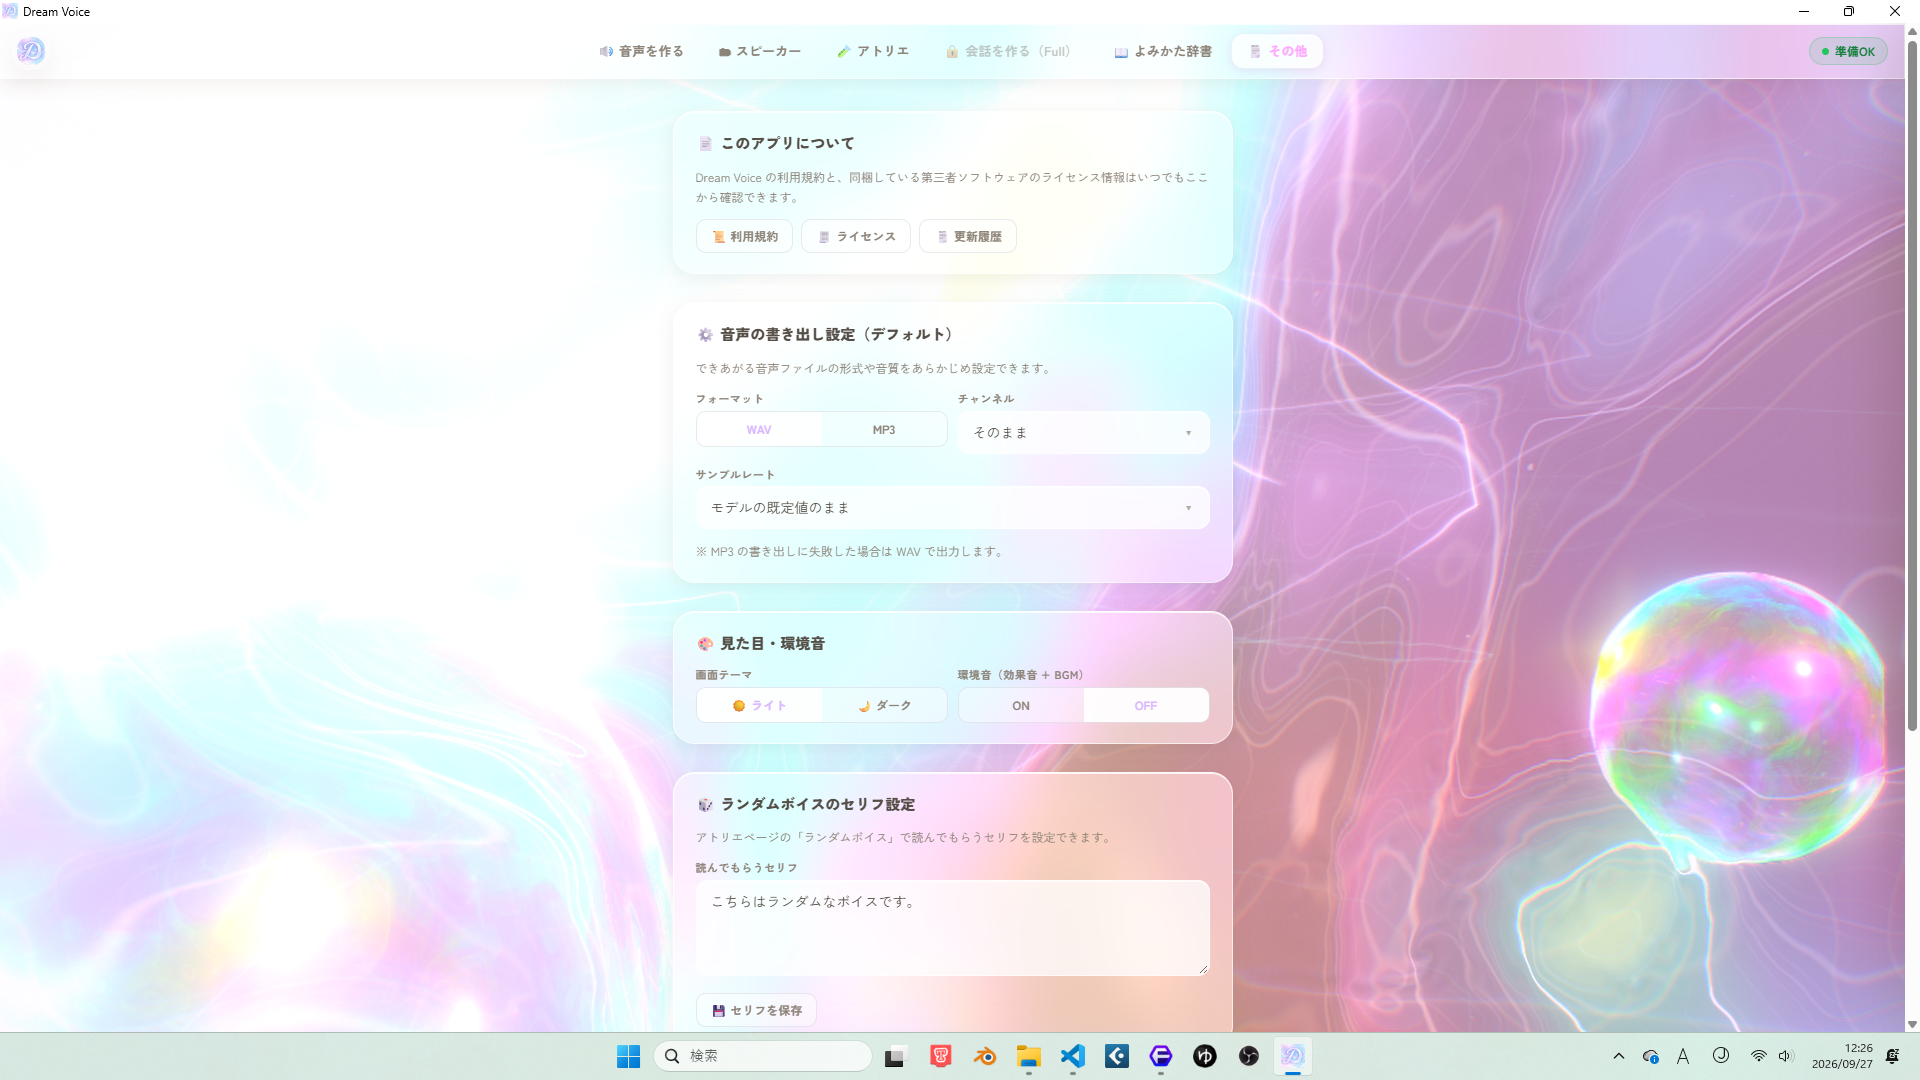
⚙️ その他(設定)
- 書き出す音声のデフォルト形式(WAV/MP3)、チャンネル(モノラル/ステレオ)、サンプルレートをあらかじめ指定できます。
- 画面テーマ(ライト/ダーク)や、アプリの環境音(効果音・BGM)の ON/OFF を切り替えられます。
- 「アトリエ」のランダムボイスで読み上げさせるデフォルトのセリフ文を設定できます。
- これまでに生成した音声ファイルをまとめて削除する機能もあります。
- 利用規約・同梱している第三者ソフトウェアのライセンス情報・更新履歴も、ここからいつでも確認できます。
FAQ
❓ FAQ・トラブルシューティング
よくある質問と、困ったときの対処法をまとめています。
⚠️ このページは準備中です。ここに、実際によく寄せられる質問・トラブル事例を今後追加していきます。
📦 インストール・起動について
(例:起動しない、モデルのダウンロードが終わらない 等)
🔊 声づくり・音声生成について
(例:声がうまく再現されない、生成に時間がかかる 等)
🧩 Full プラグインについて
(例:プラグインの導入方法、対応言語について 等)
🗂 スピーカー・パッケージについて
(例:.dvpkg の共有方法、削除の復旧について、商用利用の範囲 等)
⚙️ 動作環境・トラブル全般
(例:推奨環境、エラーが出たときの対処 等)